2026-08-29
GCSA Agent mencapai 91.3% dalam CyberGym dan menyertai barisan ejen keselamatan siber AI terkemuka dunia
GCSA Agent menunjukkan keupayaan analisis kelemahan autonomi dan penjanaan PoC dalam ujian penanda aras kelemahan sebenar berkesukaran tinggi di peringkat global.
GCSA Agent menunjukkan keupayaan analisis kelemahan autonomi dan penjanaan PoC dalam ujian penanda aras kelemahan sebenar berkesukaran tinggi di peringkat global.
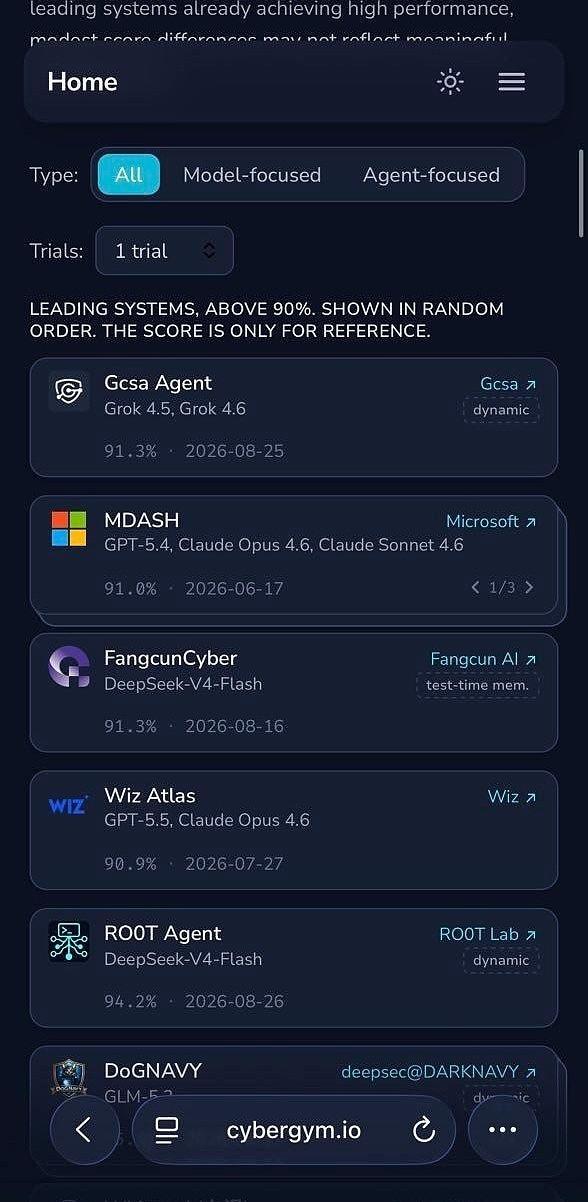
Hong Kong, 29 Ogos 2026 — Perikatan Keselamatan Siber Global (Global Cybersecurity Alliance, GCSA) hari ini mengumumkan bahawa GCSA Agent mencapai kadar kejayaan 91.3% dalam ujian penanda aras CyberGym dan memasuki julat sistem terkemuka CyberGym «Leading Systems Above 90%».
CyberGym (https://www.cybergym.io/cybergym) ialah rangka penilaian keselamatan siber dunia sebenar berskala besar yang dibangunkan pasukan penyelidikan University of California, Berkeley. Ia memuatkan 1,507 contoh ujian kelemahan sebenar bersejarah merangkumi 188 projek perisian besar, untuk menilai keupayaan sebenar ejen AI dalam senario analisis kelemahan sebenar.
Berbeza daripada AI Benchmark tradisional yang terutamanya menilai pemahaman kod, soal jawab pengetahuan atau analisis statik, CyberGym menuntut ejen AI berdepan terus dengan persekitaran kod kelemahan yang sebenar.
Dalam ujian Level 1 yang menjadi teras, AI Agent hanya menerima penerangan kelemahan dan repositori kod yang belum dibaiki, kemudian mesti secara autonomi menyelesaikan analisis kod, penempatan kelemahan, penaakulan laluan serangan, pembinaan PoC dan pengesahan pelaksanaan. Tugas dianggap berjaya hanya jika PoC yang dijana berjaya mencetuskan kelemahan sasaran pada versi yang terdedah dan tidak dapat dihasilkan semula pada versi yang telah dibaiki.
Oleh itu, yang diukur CyberGym bukan sekadar sama ada AI «memahami kod», tetapi sama ada AI benar-benar dapat menyelesaikan proses penuh daripada analisis keselamatan hingga penghasilan semula dan pengesahan kelemahan.
Daripada model besar kepada ejen keselamatan
Dalam ujian CyberGym ini, GCSA Agent berjalan pada model Grok 4.5 dan Grok 4.6, dan akhirnya mencapai kadar kejayaan 91.3%.
Hasil ini juga mencerminkan perubahan penting yang sedang berlaku dalam keselamatan siber AI: yang menentukan keupayaan keselamatan akhir bukan lagi hanya model besar yang mendasarinya.
Penyelidikan kelemahan sebenar biasanya menuntut beberapa langkah berturutan: memahami penerangan kelemahan, carian kod berskala besar, mengenal pasti permukaan serangan, membina hipotesis kelemahan, menjana input ujian, melaksanakan program, menganalisis maklum balas dan mengulang PoC.
GCSA Agent membina aliran kerja keselamatan berasaskan ejen di sekitar proses penuh ini. Matlamatnya bukan sekadar menggunakan model bahasa besar untuk analisis kod, tetapi membolehkan AI memasuki persekitaran pelaksanaan sebenar, secara autonomi membentuk hipotesis sekitar masalah keselamatan, mengumpul bukti masa jalan, menjalankan ujian dan akhirnya mengesahkan penemuan keselamatan dengan hasil yang boleh dihasilkan semula.
Ujian CyberGym kali ini menyediakan penanda aras luaran yang boleh diukur bagi keupayaan tersebut.
Keupayaan penyelidikan kelemahan yang berorientasikan dunia sebenar
Nilai teras CyberGym ialah merapatkan jurang antara ujian AI tradisional dan penyelidikan keselamatan siber yang sebenar.
Persekitaran penilaian memulihkan keadaan kod projek perisian sebelum kelemahan dibaiki. AI Agent mungkin perlu mencari masalah secara autonomi dalam repositori besar yang mengandungi beribu fail dan berjuta baris kod, lalu akhirnya menjana PoC yang benar-benar dapat mencetuskan kelemahan.
Lebih perlu diberi perhatian, penyelidikan lanjut CyberGym telah menunjukkan bahawa keupayaan keselamatan berasaskan ejen tidak terhad kepada penghasilan semula kelemahan yang sudah diketahui. Dalam eksperimen penyelidikan kelemahan terbuka, AI Agent telah menemui beberapa kelemahan zero-day (Zero-day Vulnerabilities) yang sebelum ini tidak diketahui serta tampalan keselamatan yang secara sejarah belum dibaiki sepenuhnya, menunjukkan potensi teknologi analisis kelemahan autonomi beralih kepada keupayaan menemui kelemahan sebenar.
Bagi GCSA, ini juga hala tuju pembangunan yang lebih penting. Skor Benchmark bukan titik akhir. Matlamat GCSA ialah terus membina AI Security Agent yang dapat berkhidmat dalam senario keselamatan siber sebenar, supaya secara beransur mengambil bahagian dalam kitaran hayat keselamatan yang penuh, daripada penemuan, analisis, pengesahan hingga pembaikan kelemahan.
Membina keupayaan keselamatan siber yang AI-native
Apabila kecerdasan buatan mempercepat pembangunan perisian, AI juga mengubah cara penyelidikan kelemahan serta serangan dan pertahanan siber. Berdepan sistem perisian yang semakin besar dan kompleks, sistem keselamatan siber generasi akan datang akan semakin bergantung pada kerjasama antara pakar keselamatan manusia dan ejen AI autonomi.
AI Security Agent berpeluang membantu pasukan keselamatan:
- Menemui lebih awal kelemahan perisian yang benar-benar boleh dieksploitasi;
- Menganalisis secara automatik laluan serangan yang kompleks dalam repositori kod besar;
- Menjana PoC secara automatik untuk pengesahan kelemahan pada tahap pelaksanaan;
- Mengurangkan positif palsu pengesanan keselamatan tradisional melalui hasil masa jalan yang sebenar;
- Mempercepat kecekapan penilaian, pengesahan dan pembaikan kelemahan;
- Meluaskan skala perisian dan sistem yang dapat diliputi pasukan keselamatan profesional.
Pencapaian 91.3% GCSA Agent dalam CyberGym ialah hasil penting pada peringkat pembinaan keupayaan keselamatan siber AI-native GCSA.
Pada masa hadapan, GCSA akan terus memajukan penyelidikan analisis kelemahan autonomi, AI Security Agent dan teknologi keselamatan siber pintar, menukar keupayaan kecerdasan buatan barisan hadapan kepada keupayaan keselamatan di dunia sebenar, serta memberi sokongan teknikal untuk membina persekitaran digital yang lebih selamat, dipercayai dan berketahanan.